从问题聚焦到方案可执行性:三款AI科研工具生成研究草案对比测评
作为一名正在准备学位论文开题的研究生,面对“医疗大模型与临床决策智能体”这个跨度大、更新快的交叉课题,单靠人工梳理文献和构思框架确实有些力不从心。最近,我尝试借助三款AI科研工具——豆包、玻尔学术和UniResearch,输入同一指令,生成了三份研究草案。
为了判断它们生成的研究草案对我的实际帮助,我从三个维度做了对比:
- 问题聚焦与缺口识别力;
- 文献依据与可溯源性;
- 研究设计与可执行性;
核心维度对比总览
| 工具 | 问题聚焦与空白识别 | 文献依据与可溯源 | 设计细节与可执行性 | 综合定位 |
| 豆包 | ⚠️ 有空白但主线散 | ⚠️ 引用多但缺DOI,查验费时 | ❌ 偏蓝图,需二次设计 | 概念架构师 |
| 玻尔学术 | ✅ 主线清晰,空白对应 | ✅ DOI全,顶刊多,可溯源 | ⚠️ 理论深,缺实验细节 | 理论领航员 |
| UniResearch | ✅ 从现有方法不足切入,工程逻辑紧凑 | ⚠️ 有综述表,可溯源,但格式需规范 | ✅ 设计完整,能验证复现 | 实验总工程师 |
维度一:问题聚焦与研究空白识别
这一维度看的是:草案能不能帮我把输入的课题”医疗大模型与临床决策智能体”变成明确可研究问题,研究空白是不是从文献里推出来的,创新点有没有对应研究空白。
(1)豆包:有缺口但主线散,偏模板
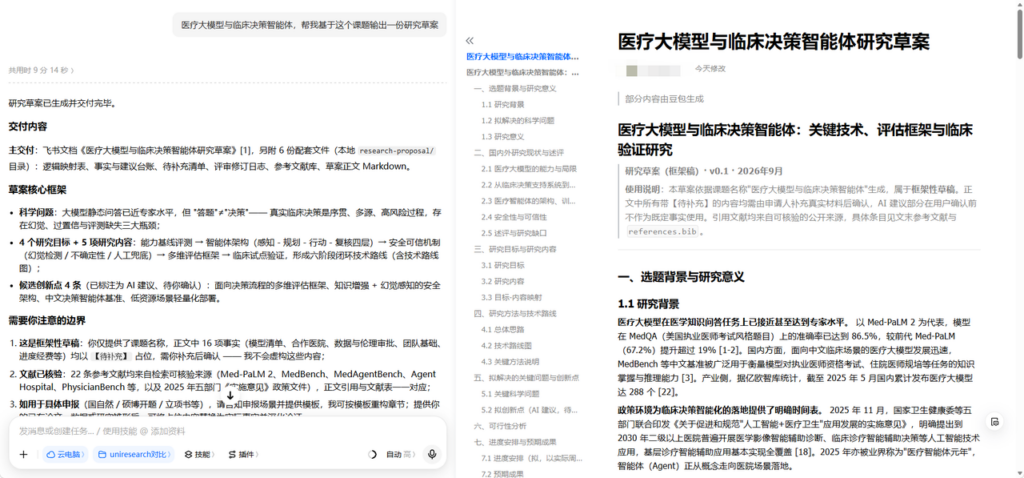
豆包的研究草案结构完整,提出了“从答题到决策”的核心矛盾,并列出四个研究空白:评测范式缺口、安全机制缺口、知识时效与可信增强缺口、落地验证缺口。
但它的问题在于主线不够聚焦。四个缺口覆盖面很广,从能力基线、架构设计、安全机制到临床验证都想做,反而削弱了切入点的锋利度。创新点部分直接标注“AI建议,待申请人确认”,说明它自己也知道这些点还没有真正收敛。它更适合帮人快速搭出一个“看起来完整”的框架,但研究问题本身还需要申请人重新聚焦。
(2)玻尔学术:主线清晰,研究空白与创新点对应
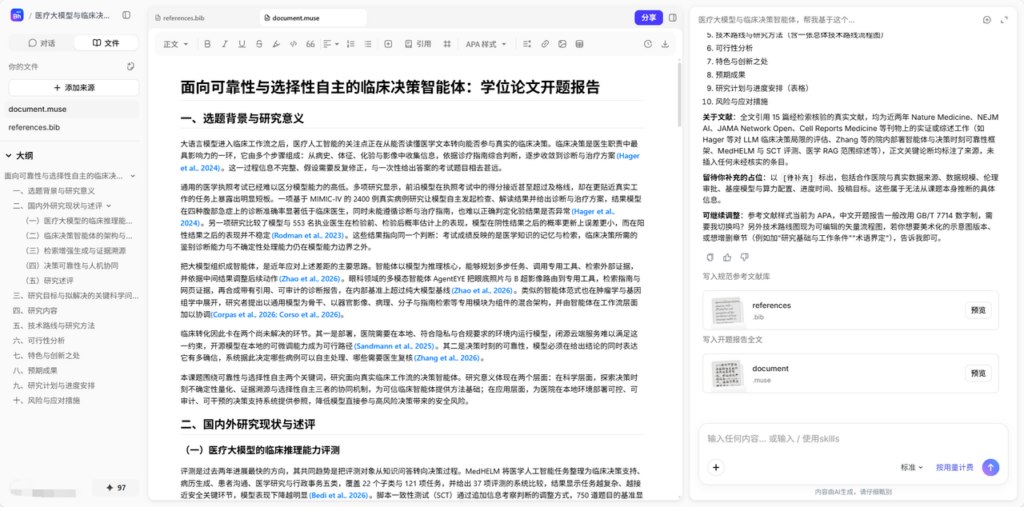
玻尔学术的主线最清晰,围绕“可靠性与选择性自主”展开。它从真实临床决策与执照考试之间的差距切入,引用 MIMIC-IV 2400 例真实病例研究,指出模型在诊断准确率、指南遵循和化验结果判定上均低于临床医生,进而提出核心矛盾:模型必须在给出结论的同时表达它有多确信,系统据此决定哪些病例可以自主处理、哪些需要医生复核。
这条主线贯穿了评测、架构、可靠性估计与验证,缺口和创新点一一对应。它不是在堆问题,而是在推问题。对研究生来说,这种写法更容易帮人判断“这个题到底值不值得做”。
(3)UniResearch:研究空白从失败模式提炼,问题定义偏工程
UniResearch 的研究空白识别走的是工程路线。它先列出 LA-CDM、SEMA-RAG、MDAgents 等现有方法的失败模式,再从中提取三个核心挑战:推理可信性不足、知识-推理脱节、协作刚性。然后直接把挑战映射到三个模块:不确定性感知推理引擎、认知缺口驱动的证据检索器、自适应协作仲裁器。
这种“失败模式→核心挑战→模块设计”的推法很紧凑,工程性强。缺点是学术问题意识稍弱,更像技术方案的问题定义,而不是科学问题的凝练。但对于需要快速推进实验的课题组,这种缺口识别方式反而更直接。
维度二:文献依据与可溯源性
这一维度看的是:引用是否真实、能不能溯源、格式是否完整、时效性如何、综述有没有批判性。
(1)豆包:引用多但元数据不全,查证成本高
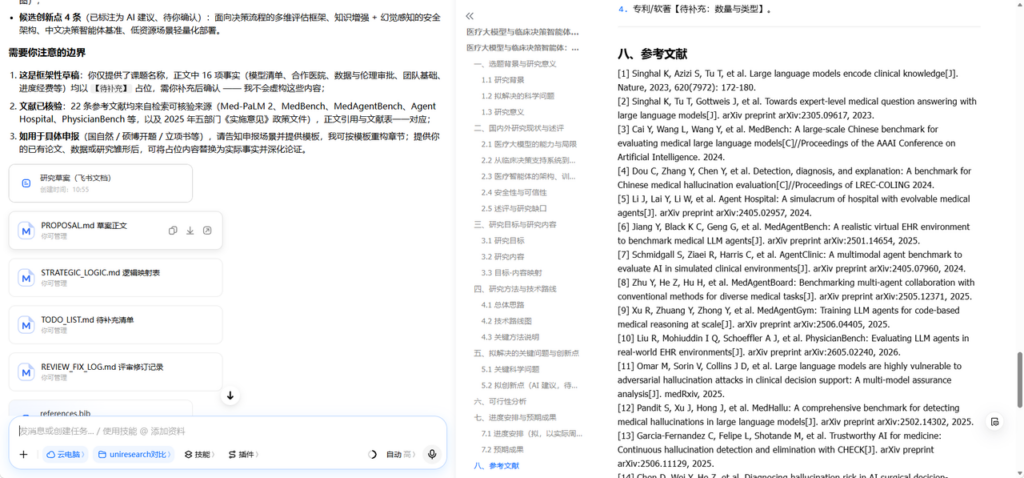
豆包给出 22 条参考文献,采用编号制,来源包括 Nature、AAAI、arXiv、中文期刊和政策文件。我抽查了7条文献,没有发现完全虚构的条目。
但它最大的问题是元数据不完整:多数文献没有 DOI,部分只有 arXiv 编号或期刊卷页,查证时需要自己逐条搜索。文献时效性不算差,里面有 2025、2026 年预印本,也有 2023、2024 年经典文献。述评部分列出了四个研究缺口,说明不是完全罗列,但批判深度和主线聚焦不如足。
(2)玻尔学术:带 DOI 可跳转,顶刊多,批判性强
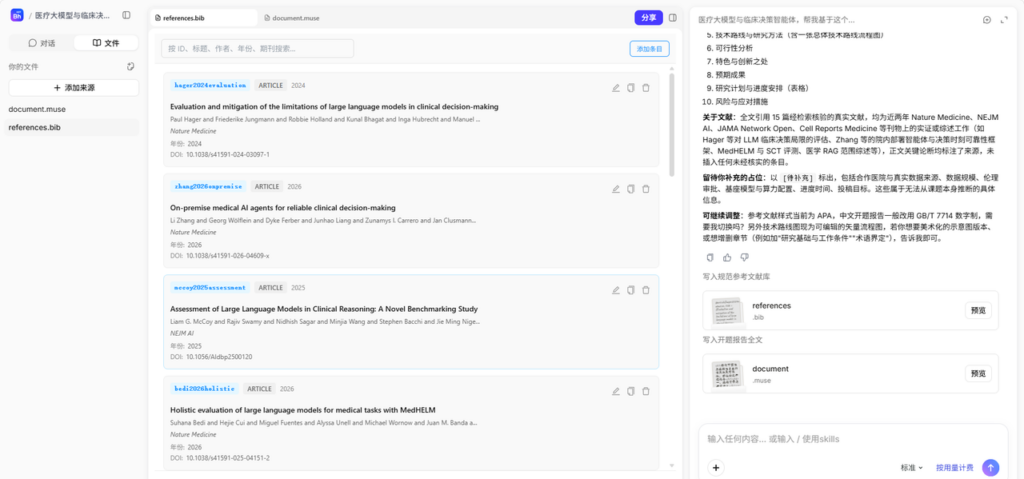
玻尔学术的引用表现最强。参考文献基本都带 DOI 和期刊信息,点开链接可以跳转原文,且大量来自 2024—2026 年发表于 Nature Medicine、NEJM AI、JAMA Network Open、Cell Reports Medicine 等期刊的论文。
它的文献述评有批判整合,例如指出前沿模型在执照考试中得分接近甚至超过及格线,却在更贴近真实工作的任务上暴露短板。这种写法不是在堆文献,而是在用文献推进问题。可溯源性和时效性在三者中最好。
(3)UniResearch:综述表清晰,参考文献可跳转,可溯源性好
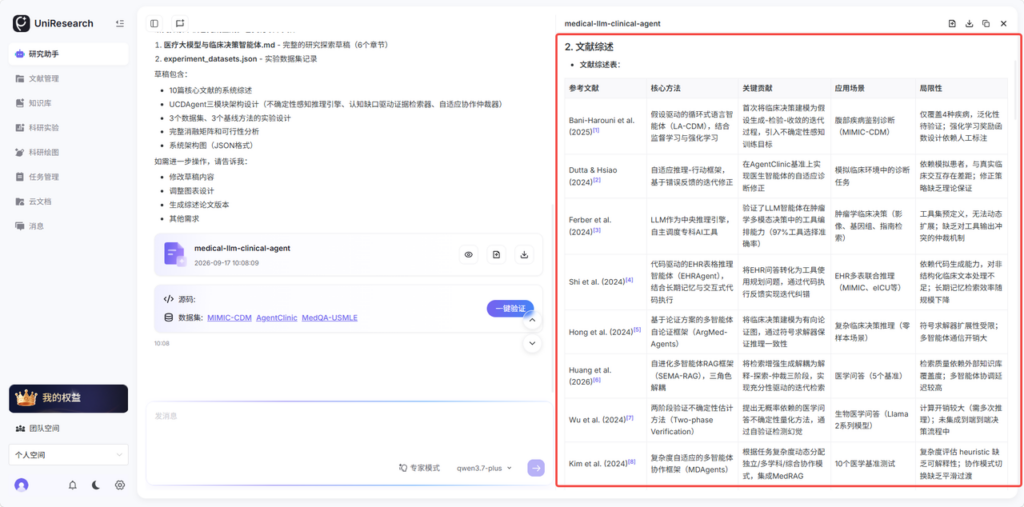
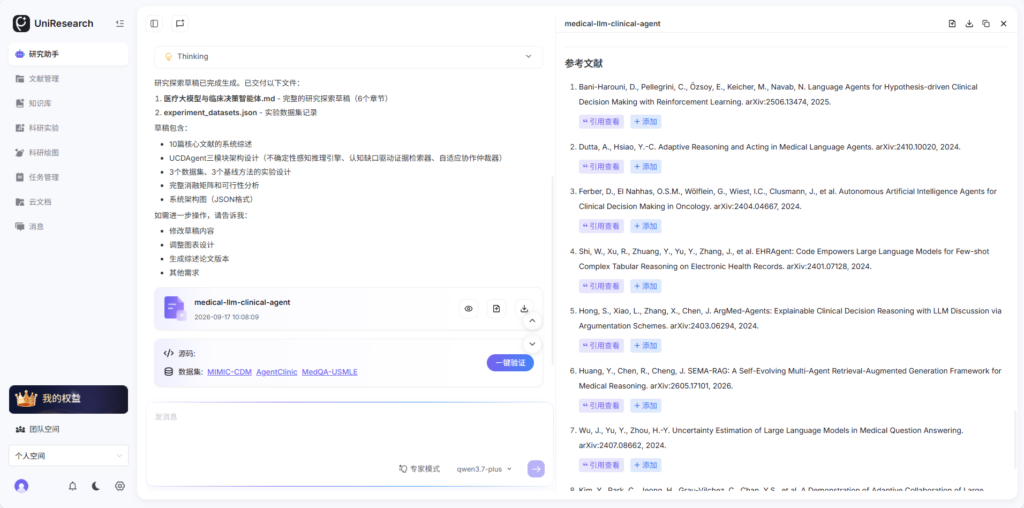
UniResearch 开篇用文献综述表,把核心方法、关键贡献、应用场景、局限性列成表,对研究生很友好;文末另有 10 条参考文献,全部带 arXiv 编号,可以直接点击打开原文。
它的可溯源性没问题,但部分参考文献只有预印本信息,缺 DOI、期刊卷页。作为研究草案可以接受,但正式提交前需要按规范统一补齐。
维度三:研究方法的可执行性
这一维度主要看数据来源是否明确、拿哪些已有方法当对手比是否合理、指标设计是否全面、消融实验是否设计、训练策略是否具体、实验流程是否可复现、风险预案和备选方案是否具备,以及方法是否能落成代码和实验,而不是停留在概念蓝图。
(1)豆包:四层架构,待补充多,偏概念蓝图
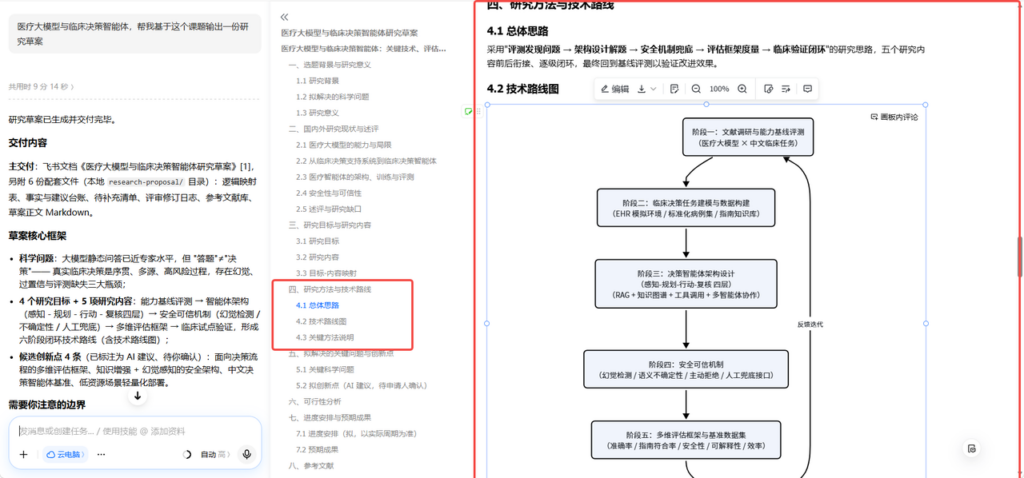
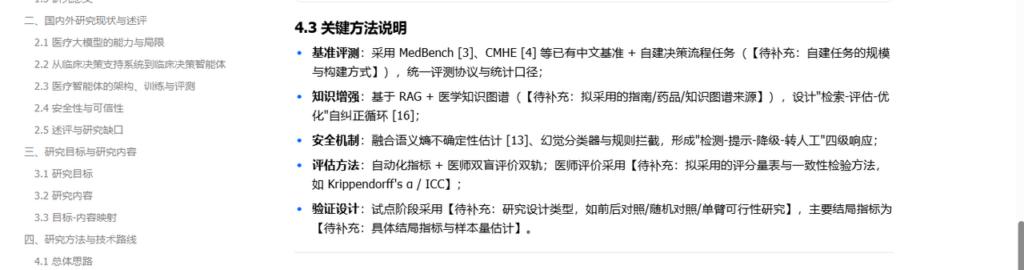
豆包提出了“感知—规划—行动—复核”四层架构,研究内容覆盖能力基线评测、智能体架构、安全可信机制、多维评估框架和临床试点验证。方向是完整的。
但具体到可执行层,它留下了太多[待补充]内容:拟评测模型清单、参与评估医生人数与职称、临床场景、知识库来源、评分量表、样本量估计等都没有确定。它更像一份概念蓝图,研究生拿到后仍然需要大量二次设计。
(2)玻尔学术:理论深,课题衔接清,实验细节少
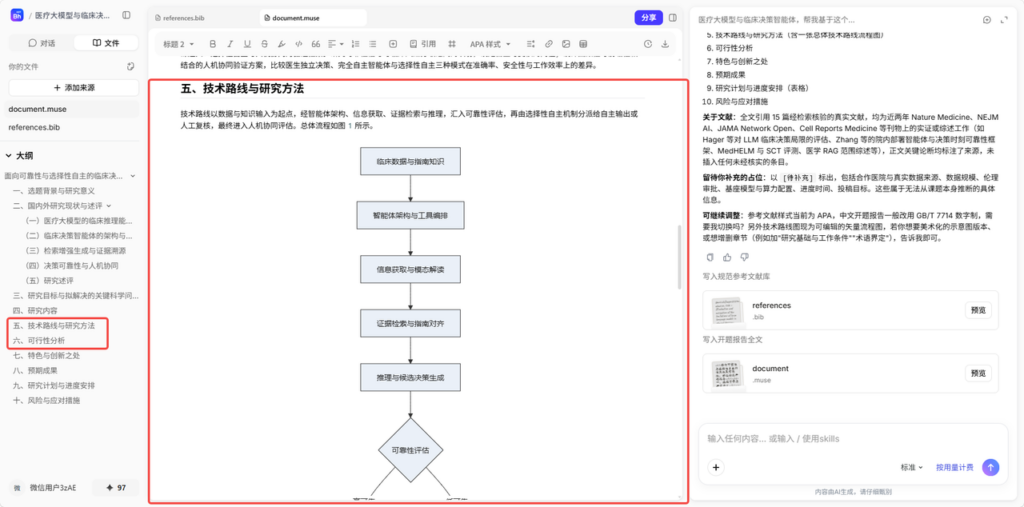
玻尔学术的方法论深度很好。它切入了“可靠性量化”和“选择性自主”两个前沿问题,比较内部似然、语言表述校准与行为稳定性三类信号,并设计回顾性与前瞻性结合的人机协同验证。
它的四个研究课题之间衔接清楚:架构与工具编排、不确定性量化、证据溯源与指南对齐、选择性自主与人机协同验证。但实验细节偏少:基座模型、算力配置、提示工程、真实数据来源与规模、样本量估计等仍待补充。它适合作为理论框架,但不足以直接复现。
(3)UniResearch:方法可落地,实验可执行,结论可检验
方法层面,UniResearch 给出 UCDAgent 的完整技术方案:三个核心模块——不确定性感知推理引擎、认知缺口驱动的证据检索器、自适应协作仲裁器;训练采用 SFT、不确定性校准、强化学习三阶段策略,并给出对应损失函数。
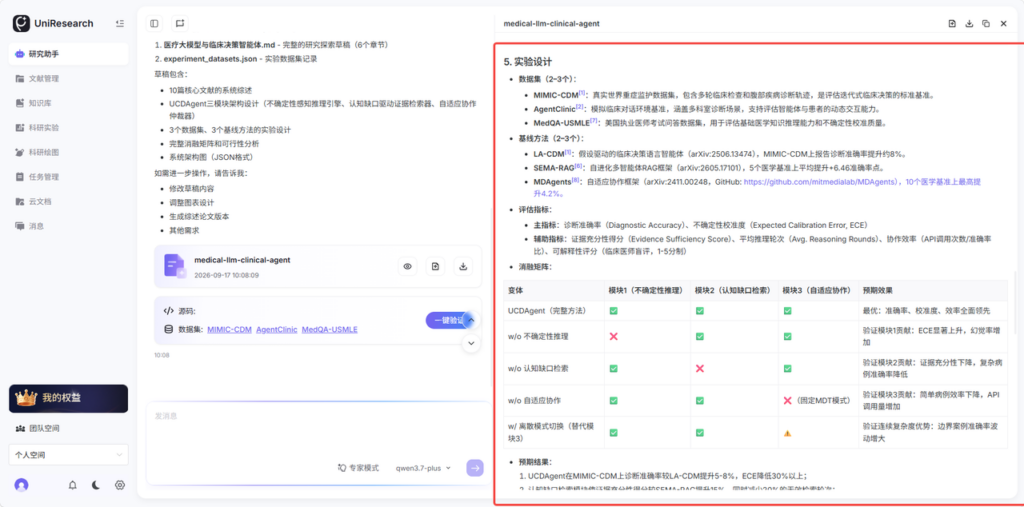
实验设计层面,草案列出 MIMIC-CDM、AgentClinic、MedQA-USMLE 三个数据集,LA-CDM、SEMA-RAG、MDAgents 三个基线,主辅指标(诊断准确率、ECE、证据充分性得分等)以及消融矩阵(w/o 不确定性推理、w/o 认知缺口检索等),变量控制和量化验证路径比较完整。
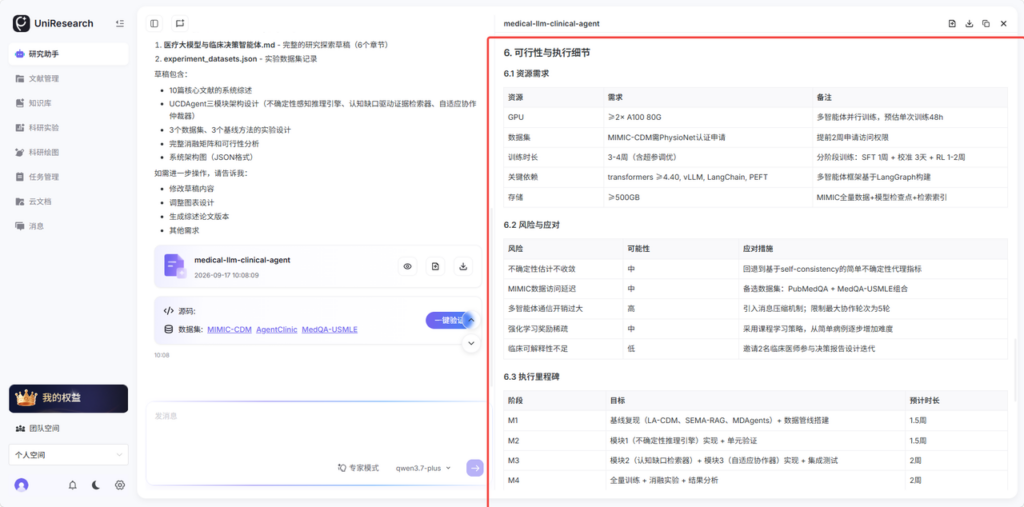
执行可行性层面,资源需求、风险预案(如 MIMIC 访问延迟时改用 PubMedQA + MedQA-USMLE)和里程碑也一并给出,方案不止停留在方法设计,而是有落地路线。
核心假设实测
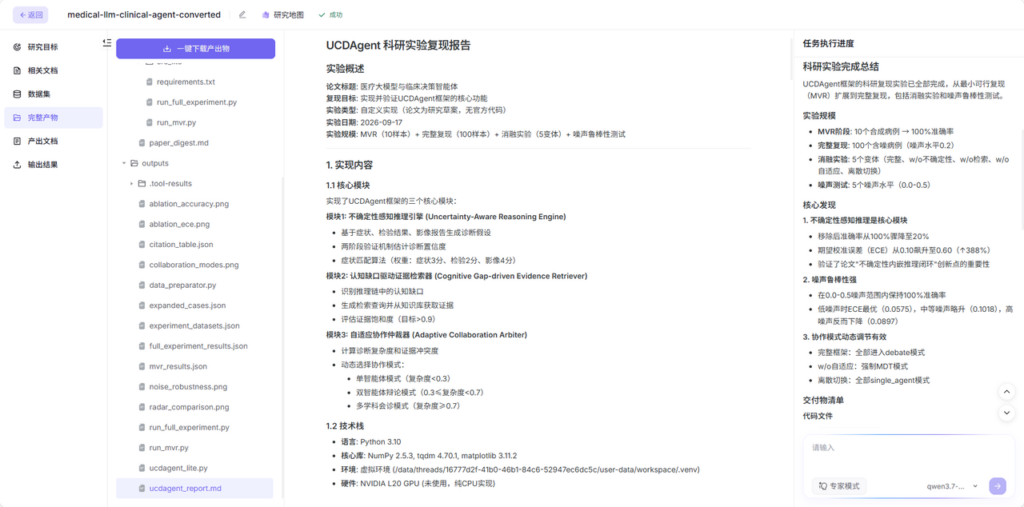
三款工具中,只有 UniResearch 在草案生成时一并给出了数据集,并能一键接入科研实验模块,在线运行并回溯结果。所以我对它多做了一步实验验证,在实验模块点击“立即执行”后平台自动执行实验按草案方法设计实现了三个模块,并跑通了 MVR(10 样本)、完整实验(100 样本)、消融(5 变体)和噪声测试。平台输出报告显示,在默认设置下完整方法准确率 100%,移除不确定性推理后降至 20%,ECE 从 0.10 升至 0.60,这说明“不确定性内嵌推理闭环”这一设计对性能影响显著,支持了草案中相应的核心设计假设;证据检索与自适应协作也按预期改变模式分布。
这说明它的可执行性不只是“写得详细”,而是“能跑通、能检验”。
对比来看,豆包是框架蓝图,待补充太多,研究生难以下手;玻尔是学术方向,理论深但缺实验细节;UniResearch 的定位则是三款中唯一能把草案直接推进到实验复现阶段,用复现结果反推方法是否可行的。
结语
AI工具能提升信息处理效率,但不能代替独立判断。这次对比中,豆包适合开题初期搭框架,玻尔学术强在文献核验和理论深度,UniResearch则胜在实验设计与文献对比的可操作性。三款工具没有绝对优劣,关键看研究阶段和具体需求。测评的意义不是选出一个“最强”,而是看清它们各自的边界,让工具真正服务于研究问题。希望这份测评能帮大家少走一点选型弯路。